寄り道の見返りは、遅れて届くヒンメルの迷宮で考える 満足化・最大化・探索
『葬送のフリーレン』の勇者ヒンメルは、ダンジョンが大好きでした。魔王を倒す旅の途中でも、寄り道を惜しみません。ゴールに着いているのに、なぜ全部の部屋を見て回るのか。この問いから、サイモンの「満足化」、シュワルツらの「最大化」、マーチの「探索と深化」へと考えをつなぎます。後半では、同じ話を縦型のショート動画にしたときの作り方を記録します。
- 探索に手間がかかるなら、「十分」で止めるのは賢い(満足化)
- 全部を確かめる人は、良い結果を得ても満足しにくい(最大化)
- 探索の見返りは不確実で、遅れて届く。だから組織は探索を後回しにしやすい(探索と深化)
1. 問いの始まり:「どう勝つか」と「どこまで探すか」は別の軸
最初に考えていたのは、孟子の「王道と覇道」でした。徳で人を従わせるか、力で屈服させるか。これは手段の区別です。ところが、ダンジョンを隅から隅まで回るか、最短で抜けるかという違いは、王道か覇道かでは分けられません。どちらの勇者も、寄り道をすることも、しないこともできます。
そこで、探索の深さを手段とは別の軸として切り出しました。この軸については、意思決定の研究に三つの古典があります。
2. 満足化:人は最適ではなく「十分」で探すのをやめる
ハーバート・サイモンは1955年に、選択肢を全部比べて最適なものを選ぶ、という合理性のモデルに疑問を出しました。人は、あらかじめ決めた期待水準を満たす選択肢が見つかった時点で、探すのをやめる。1956年の論文で、彼はこれを satisfice(満足化)と名付けます。
面白いのは、その1956年の論文のモデルです。生き物が暮らす空間を、迷路のように枝分かれした道として描いています。分かれ道のいくつかに餌があり、生き物に見えるのは数手先までです。サイモンの満足化は、もともと迷路を探す話でした。
満足化が賢いのは、探すことに手間がかかるときです。下の図で確かめられます。宝箱が8つ並び、開けた箱だけ、後ろのガラス管に宝の価値が満ちます。珊瑚色の棒が期待水準です。青い台車(満足化)は、期待水準を超えた最初の箱で止まります。灰の台車(最大化)は全部開けて一番よいものを取ります。
図1 どこで、探すのをやめるか。期待水準と「1部屋の手間」をつまみで変えられます。別の画面で開く
宝の値は例として 40・55・82・60・95・30・70・88、期待水準は70にしています。正味(宝の価値 − 1部屋の手間 × 開けた箱の数)で比べると、手間が2なら最大化が上(79対76)、手間が3なら満足化が上(73対71)です。この例では、手間が約2.6を超えたところで満足化が逆転します。手間がゼロなら全部確かめるのが得で、手間が上がるほど「十分で止める」が得になる。満足化は怠けではなく、手間まで勘定に入れた合理性です。
3. 最大化:より良くやって、より悪く感じる
では、全部を確かめる人はどうなるのか。バリー・シュワルツらは2002年に、何でも最良を求める傾向(最大化)を測る尺度を作りました。最大化の傾向が強い人ほど、幸福感・楽観・生活の満足度が低く、後悔や抑うつが強い、という相関が出ています。
2006年には、アイエンガー、ウェルズ、シュワルツが、11大学の卒業予定者548人の就職活動を追いました。最大化の傾向が強い学生は、初任給が20%高い職を得ていました。それなのに、得た職への満足度は低く、就職活動中の否定的な感情も多かった。論文の題は「より良くやって、より悪く感じる(Doing Better but Feeling Worse)」です。
図1で言えば、灰の台車は一番高い宝を取りますが、そのために全部の箱を開けています。成果は最大でも、その途中で「もっと良いものがあったのでは」と確かめ続けている。最大化の人の満足しにくさは、この確かめ続ける姿勢から来ると考えられています。
4. 探索好きは、最大化とは違う
ここで最初の問いに戻ります。ヒンメルも全部の部屋を見て回ります。行動だけを見れば、最大化の人と同じです。でも、ヒンメルを「最良を逃すのが怖い人」と呼ぶのは、しっくりきません。
違いは動機です。最大化の人は、最良を逃す不安から全部を確かめます。探索好きの人は、探すことそのものを楽しんでいる。同じ行動でも、動機が違えば別の型です。
そしてこの記事では、もう一つの違いを置きました。後に何が残るかです(ここは筆者の解釈です)。図1の金の台車は、灰と同じ箱を同じ順に開け、同じ宝を取ります。違うのは、開けた箱に灯りを残していくことだけです。灯りの値打ちは、この図の正味では数えていません。数えられないものとして残しています。
5. 探索と深化:見返りの時間がずれている
組織の学習を論じたジェームズ・マーチは、1991年の論文で、新しい可能性を探る探索(exploration)と、手持ちの知識を磨いて使う深化(exploitation)を対比しました。マーチによれば、深化に比べて探索の見返りは、より不確実で、時間的に遠く(more remote in time)、組織の中でも行動の現場から離れています。
だから、経験から学ぶ組織は、深化のほうを速く磨きます。深化は手早く確かな見返りを返すからです。これは短い目で見ると有効ですが、長い目で見ると自分を損なう、とマーチは書いています。
ヒンメルは、魔王討伐という本筋(深化)をやり遂げた勇者です。そのうえで、寄り道(探索)を惜しまなかった。本筋と寄り道の両方を持つ「両利き」の勇者です。そして物語は、魔王討伐から50年後、ヒンメルが亡くなったところから始まります。寄り道だらけの旅の意味は、その後になって、残された仲間の旅の中で届いていきます。
6. あなたのチームに、ヒンメルはいますか
研究開発や知財の仕事に引き寄せると、問いは具体的になります。
- 評価の期間が四半期や1年なら、見返りが遅れて届く探索は、ほぼ必ず負けて見えます。負けて見えることと、価値がないことは別です。
- 「十分」で止める満足化は、手間のかかる仕事ではむしろ正しい判断です。全員に最大化を求めると、成果は上がっても、人が擦り減るかもしれません。
- 寄り道を許すなら、寄り道が何を残したか(灯り)を記録しておく。50年とは言わなくても、数年後に誰かがその灯りを道しるべにできます。
7. 制作記録:同じ話を、縦型のショート動画にする
この論考は、もともと60秒の縦型動画の企画として始まりました。企画の芯は「感銘で引き込み、知的興奮で締める」です。ここからは、その動画をどう作ったか、どこでつまずいたかの記録です。費用はかけず、手元の道具だけで作っています。
7-1. 最初の版は「説明」になっていた
最初は、Claude にコードで図を描かせて動画にする方法(canvas に時刻ごとの1コマを描き、MP4 に書き出す)で、絵コンテどおりに作りました。光の点が迷路を降り、棒グラフで満足化を見せる版です。見た感想は「説明的」でした。
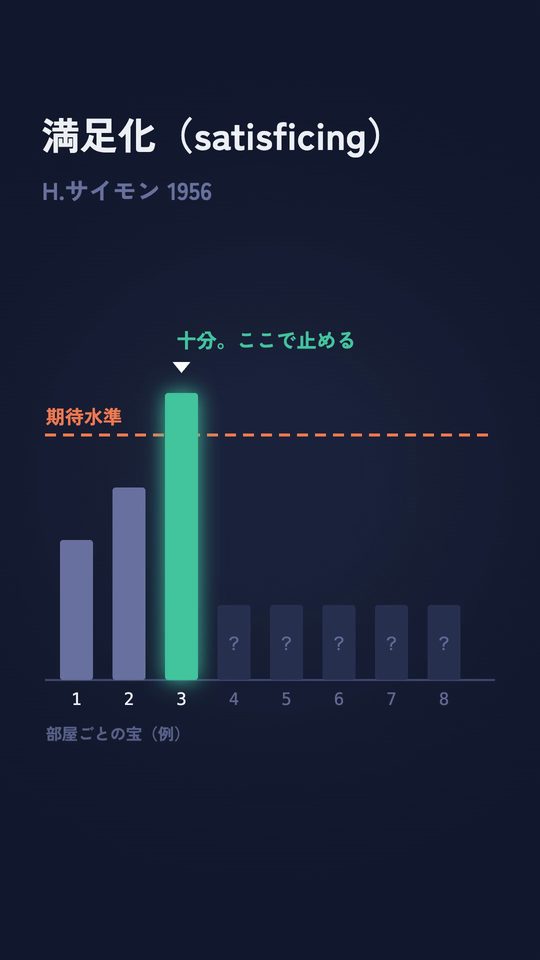
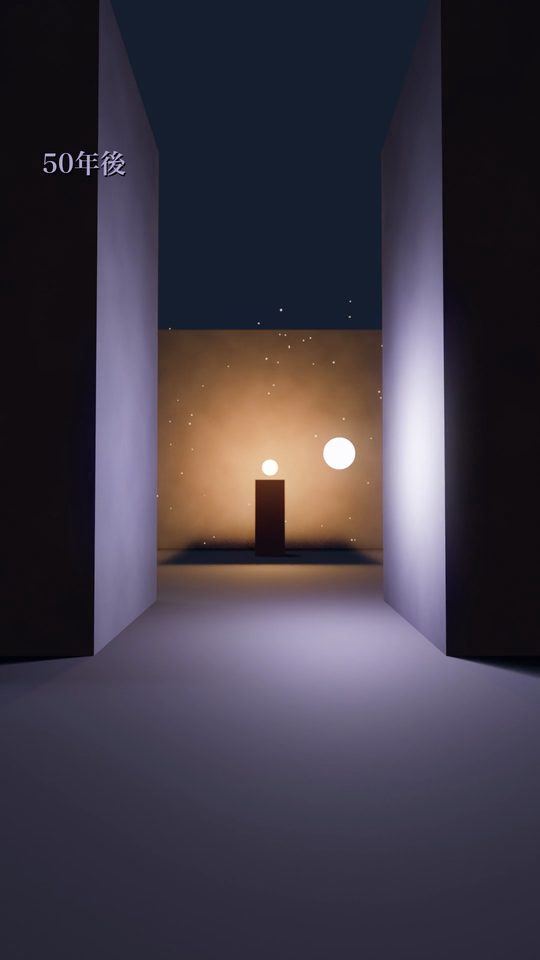
原因を書き出すと、次の4つでした。テロップが状況を先に言ってしまう。真上からの図しかなく、主人公の隣に立てない。選択が棒グラフの比較になり、迷いが消える。結論が先に来る。要するに、言って分からせて(Tell)いて、見せて気づかせて(Show)いませんでした。
7-2. 撮影と演出の道具を当てる
| 道具 | この動画での使い方 |
|---|---|
| カメラの高さ=抽象度 | 目線の高さは体験、真上は理論。上昇しながら地図になり、理論へ切り替わる |
| 光は物語の中にあるものだけ | 勇者のたいまつ・ランタン・宝だけが光る。「灯る=探索した」を画面全体で守る |
| 色に役を持たせる | 金=探索、青=満足化、灰=最大化、珊瑚色=期待水準 |
| 選ぶ前の間 | 宝の光に一歩吸い寄せられ、止まってから、暗い脇道へ曲がる |
| 仕込みと回収 | 寄り道で灯したランタンが、50年後もまだ灯っている |
| 先に見せて、後で名付ける | 理論の名前は、最後に地図へ書き込む形で出す |
7-3. 別の目のレビューで、理論を戻す
ドラマに寄せた版を、制作に関わっていない別のエージェントに読んでもらいました。指摘は鋭く、特に次の3つが効きました。
- 理論の名前を全部外したのは行き過ぎ。「先に見せて、後で名付ける」にすればよい。
- 満足化と最大化を、同じ青い光ひとつにまとめている。企画の核心は「探索好きは最大化と違う」なのに、そこが描けていない。→ 旅人を青・灰・金の3人に分けた。
- 効率の側を悪役にしない。ヒンメルは本筋もやり遂げた両利きの勇者。→ 金の旅人にも宝を取らせ、対立を善悪でなく見返りの時間差として描いた。
7-4. 4種類の素材を、カメラの高さでつなぐ
最終的なプリビズ(本番の前に、動きと尺を確かめる下書きの動画)は、4種類の素材をつないでいます。
| 素材 | 担当 | 作り方 |
|---|---|---|
| 画像から動画 | 主人公の芝居(歩く・宝に笑う・見上げる) | 筆者が用意した主人公の絵を、公開モデル Wan2.2-TI2V-5B(Apache-2.0)で5秒ずつ動かす。手元の GPU で1本約7分半 |
| Blender | 上昇・理論の空間・50年後 | Python で迷路と光を組み、カメラを動かして書き出す |
| 2Dゲーム | 全体の地図と、理論の名付け | ドット絵の見下ろし画面を canvas で描く。3人の道筋を地図に書き込む |
| 押して動く図 | 付録(この頁の図1) | Claude Code のスキル anatomy で、模型から動きと数字を出す |
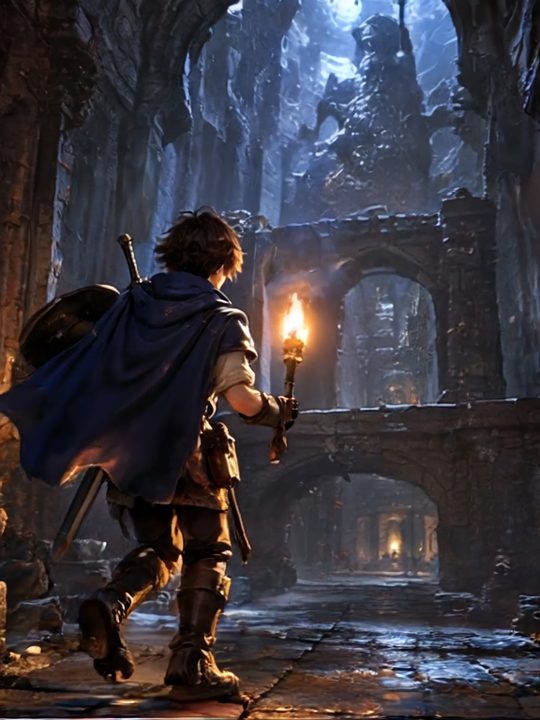
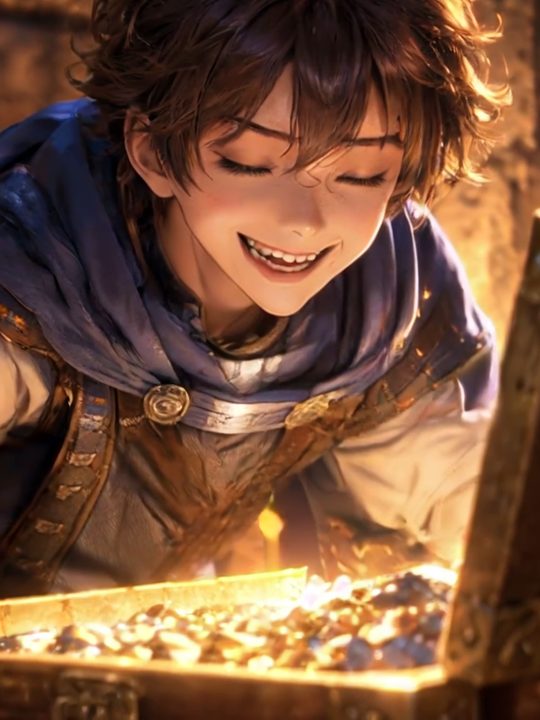
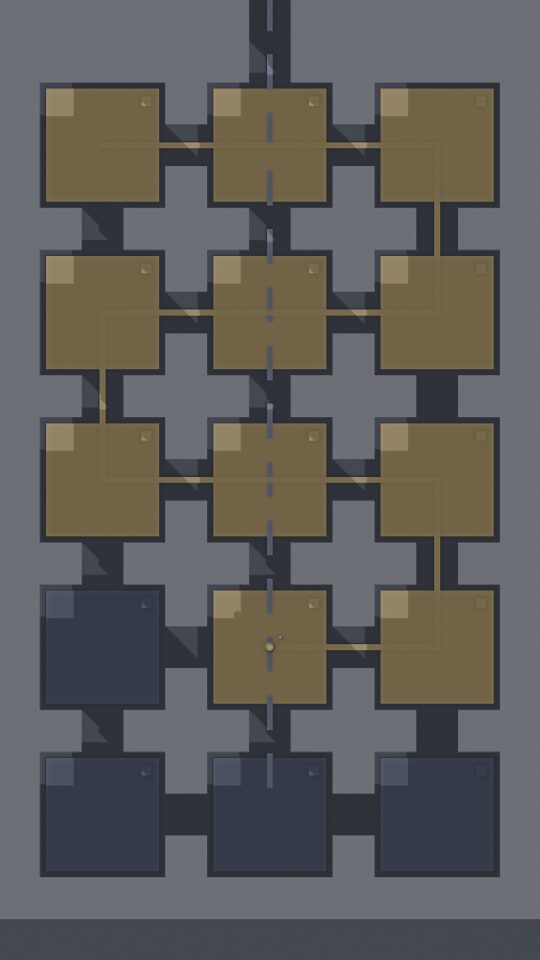
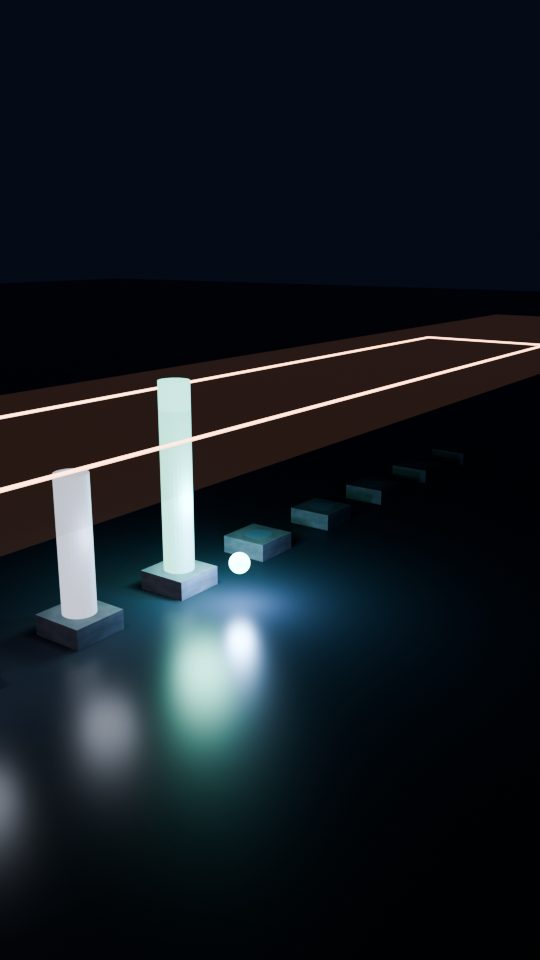
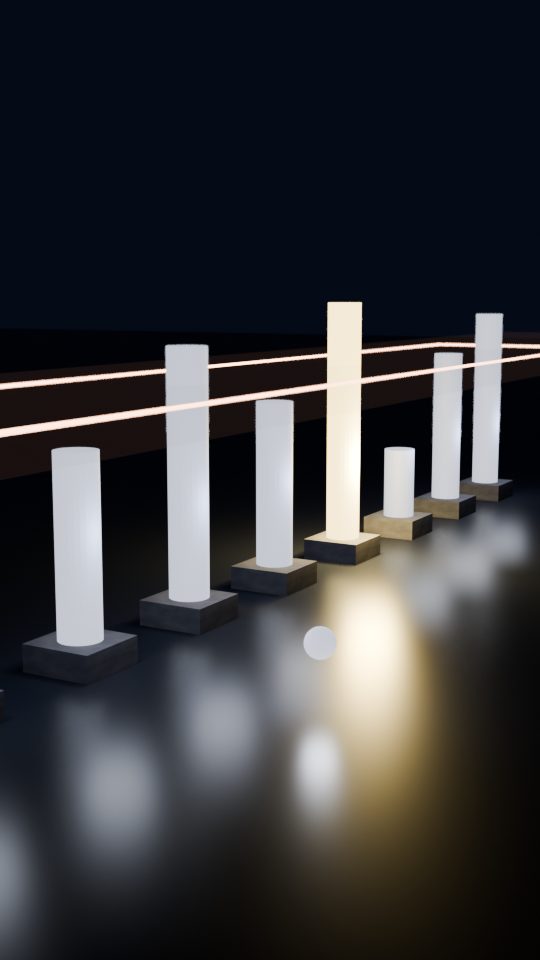
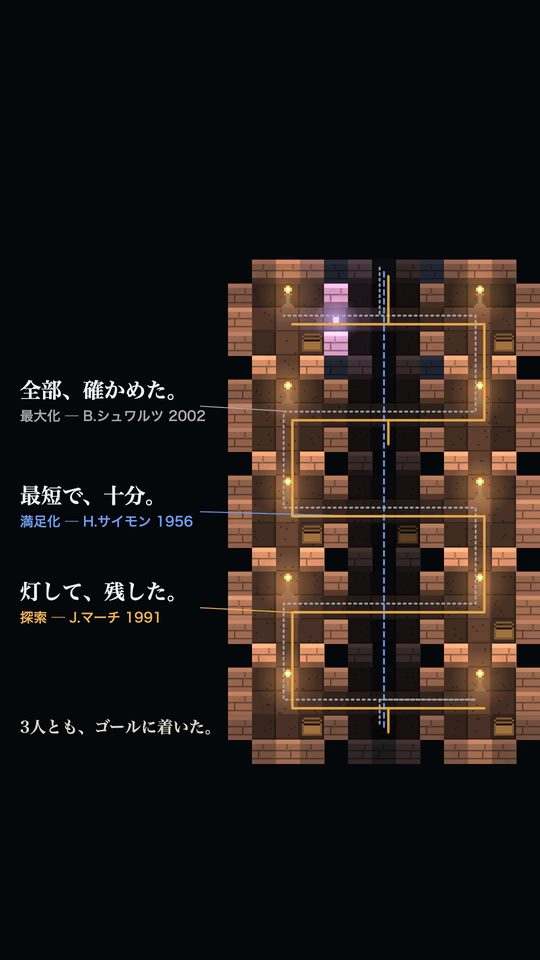
素材が混ざると画がばらつきます。そこで、つなぎ目をカメラの高さにそろえました。目線の高さの体験は画像から動画と Blender、上から見る全体像と理論は2Dゲームの地図、と分担し、上昇して真上に届いた瞬間に地図へ切り替えます。カメラが上がるほど抽象度も上がる、という作りです。
7-5. 作ってみて分かったこと
- カメラと尺は、生成モデルに任せない。Blender の下書き動画で先に決め、モデルには人物の芝居だけを頼むと、ショットがつながる。
- 理論を消すのではなく、置く場所を変える。理論は冒頭に説明するより、最後の俯瞰で「名付け」として出すほうが、気づきとして残る。
- レビューは、作った本人と別の目で。満足化と最大化を一つにまとめていたことに、作った側は気づけなかった。
- 試作は静止画から。見た目は数枚の静止画で決め、全コマの書き出しは最後にする。往復が数倍速くなる。
この動画の現在地 プリビズを仕上げ、完成版をこの節の冒頭に載せました。最後に、制作に関わっていない別の目で見てもらい、テロップの位置、訳し漏れ、音量を直しています。
参考文献と出典
- Simon, H. A. (1955). A Behavioral Model of Rational Choice. The Quarterly Journal of Economics, 69(1), 99–118.
- Simon, H. A. (1956). Rational Choice and the Structure of the Environment. Psychological Review, 63(2), 129–138.
- Schwartz, B., Ward, A., Monterosso, J., Lyubomirsky, S., White, K., & Lehman, D. R. (2002). Maximizing Versus Satisficing: Happiness Is a Matter of Choice. Journal of Personality and Social Psychology, 83(5), 1178–1197.
- Iyengar, S. S., Wells, R. E., & Schwartz, B. (2006). Doing Better but Feeling Worse: Looking for the “Best” Job Undermines Satisfaction. Psychological Science, 17(2), 143–150.
- March, J. G. (1991). Exploration and Exploitation in Organizational Learning. Organization Science, 2(1), 71–87.(探索の見返りについての記述は p.73「The Vulnerability of Exploration」)
- 『葬送のフリーレン』(原作:山田鐘人、作画:アベツカサ、小学館)。ヒンメルのダンジョン好きはアニメ第23話「迷宮攻略」の描写による(電撃オンラインの紹介)。魔王討伐から50年後の設定はザテレビジョンの番組概要による。
作品の画像・映像・キャラクターの絵・セリフは使っていません。動画の主人公の絵は筆者が用意したものです。図1は anatomy(Ryan 作、MIT License)の kit を使って作成しました。